全站目录 · 按任务查找
1.6 原始文件完整流程
把原始 FASTA、GFF3 和标准 BLAST 表格组合成一张可追溯的序列比较图。你将检查输入、选择显示子集,再对照弦图与全长概览。
本页准备
在新的 R 会话中先运行下方代码,再按页面顺序继续。配色和排版是可选的显示设置,输入只选择需要的列。 涉及文件时,先解压教学输入,使工作目录包含 examples/。
准备代码 · 在本页运行一次
代码
# Optional appearance choices; none of these columns or scales is required input.
library(ggchord)
seq_palette <- setNames(
  c("#E64B35", "#233E4A", "#269B82", "#D59B17"),
  c("MT108731.1", "MT118296.1", "OQ646790.1", "OR222515.1")
)
gene_palette <- c("+" = "#CE1536", "-" = "#346B9D", "." = "#8291A6")

library(ggchord)
doc_background <- "#FFFCF5"
identity_palette <- c("#303B71", "#36537D", "#269B82", "#A5D52C", "#ECEB31")
identity_values <- c(0, 0.5, 0.8, 0.9, 1)
identity_breaks <- c(0, 50, 80, 90, 100)
doc_legend_theme <- theme(
  legend.title = element_text(size = 13, face = "bold"),
  legend.text = element_text(size = 11),
  legend.key.width = unit(9, "mm"), legend.key.height = unit(5, "mm"),
  legend.spacing.x = unit(9, "mm"), legend.spacing.y = unit(7, "mm"),
  legend.margin = margin(l = 4, r = 4, unit = "mm")
)
sequence_guide <- guide_ggchord_legend(nrow = 1, theme = doc_legend_theme)
strand_guide <- guide_ggchord_legend(
  nrow = 1, override.aes = list(strand = c("+", "-")), theme = doc_legend_theme
)
identity_guide <- guide_ggchord_colourbar(
  position = "left", direction = "vertical",
  theme = theme(
    legend.key.height = unit(75, "mm"), legend.key.width = unit(5, "mm"),
    legend.title = element_text(size = 13, face = "bold"),
    legend.text = element_text(size = 11), legend.margin = margin(r = 7, unit = "mm")
  )
)
doc_theme <- theme_ggchord_publication(
  axis.text = element_text(size = 11),
  axis.text.check.overlap = TRUE
) +
  theme(
    legend.position = "bottom",
    legend.title = element_text(size = 13, face = "bold"),
    legend.text = element_text(size = 11),
    legend.key.width = unit(9, "mm"), legend.key.height = unit(5, "mm"),
    legend.spacing.x = unit(9, "mm"), legend.spacing.y = unit(7, "mm"),
    legend.box.spacing = unit(6, "mm"),
    plot.background = element_rect(fill = doc_background, colour = NA),
    panel.background = element_blank(),
    plot.title = element_text(face = "bold", size = 18),
    plot.subtitle = element_text(size = 10, colour = "#5C625A"),
    plot.margin = margin(14, 18, 14, 18)
  )
doc_axis <- function(coordinates = "relative") {
  scale_seq_position_continuous(
    coordinates = coordinates, n.breaks = 3, minor_breaks = NULL,
    labels = function(x) format(x, scientific = FALSE, big.mark = ",", trim = TRUE)
  )
}
这条完整工作流使用源码仓库已有的四条序列记录,不需要重新比对或预测基因。 使用匹配的开发 checkout,或下载教学输入,解压后让 工作目录下包含 examples/。保存图形时同时记录包版本与构建清单。
1. 读取并检查原始记录
代码
library(dplyr)
sequence_source <- read_fasta_lengths(files = "examples/fasta/*.fna", source_file = TRUE)
seq_real <- sequence_source |>
  select(accver, length)
annotation_source <- read_gff3(files = "examples/gff3/*.gff3", unstranded = "keep", source_file = TRUE)
feature_real <- annotation_source |>
  select(accver, start, end, strand, type, anno)
alignment_source <- read_blast(files = "examples/blastn-standard/*.tsv", source_file = TRUE)
link_real <- alignment_source |>
  select(qaccver, saccver, qstart, qend, sstart, send, pident, length)
real_validation <- validate_ggchord_data(seq_real, link_real)
real_validation
FASTA 头部提供原样 accession version 与长度,GFF3 提供 CDS 区间和真实链方向, BLAST 文件提供已有比对;读取器不运行 BLAST。继续前检查 real_validation: 连接端点递减可能是合法的反向命中。不能把未知注释链改成 + 来满足基因快捷层。
2. 明确显示筛选规则
代码
real_prepared <- prepare_ggchord_data(seq_real, link_real,
  features = list(annotation = feature_real)
)
real_filtered <- filter_ggchord_ribbons(link_real, min_pident = 80, min_length = 500)
# Explicit display subset: the six longest CDS per sequence; raw annotations stay intact.
real_display_features <- feature_real |>
  group_by(accver) |>
  slice_max(end - start + 1, n = 6, with_ties = FALSE) |>
  ungroup()
real_labels <- real_display_features |>
  filter(anno != "hypothetical protein") |>
  group_by(accver) |>
  slice_head(n = 2) |>
  ungroup()
real_filtered$report| 项目 | 结果 |
|---|---|
| 序列数 | 4 |
| 注释记录数 | 266 |
| 弦图中选出的 CDS 数 | 24 |
| 原始比对记录数 | 32 |
| 通过显示筛选的比对数 | 8 |
| 选出的文字标签数 | 6 |
显示连接保留相似度 ≥80%、已报告比对长度 ≥500 bp 的记录。弦图每条序列选择最长 六条已导入 CDS,并在这些 CDS 中最多标记两条非 hypothetical protein 注释。这是显示规则,不是生物学结论,未显示的 基因不表示不存在。原始 feature_real、link_real 不变,real_prepared$report 和 real_filtered$report 保留准备与筛选证据。链方向不重编码;这与生成说明中 明确进行显示链重编码的小型随包教学 fixture 不同。
3. 构建弦图比较
代码
p_real_chord <- ggchord(seq_data = seq_real, ribbon_data = real_filtered$data, validate = "none") +
  geom_link_ribbon(aes(ribbon_fill = pident), alpha = .65) +
  geom_seq(show.legend = FALSE) +
  geom_feature(aes(feature_fill = strand),
    data = real_display_features,
    width = .045, position = position_strand(.08)
  ) +
  geom_feature_label_repel(
    data = real_labels, label_layout = "radial",
    label_wrap = 20, size = 4, position = position_strand(.08)
  ) +
  geom_seq_label(size = 4, seq_label_radius = .84, seq_label_hjust = .5) +
  coord_chord() +
  scale_seq_colour_manual(values = seq_palette) +
  scale_feature_fill_manual(values = gene_palette, breaks = c("+", "-")) +
  scale_ribbon_fill_gradientn(
    colours = identity_palette, values = identity_values,
    limits = c(0, 100), breaks = identity_breaks, name = "Identity (%)", guide = identity_guide
  ) +
  doc_theme
p_real_chord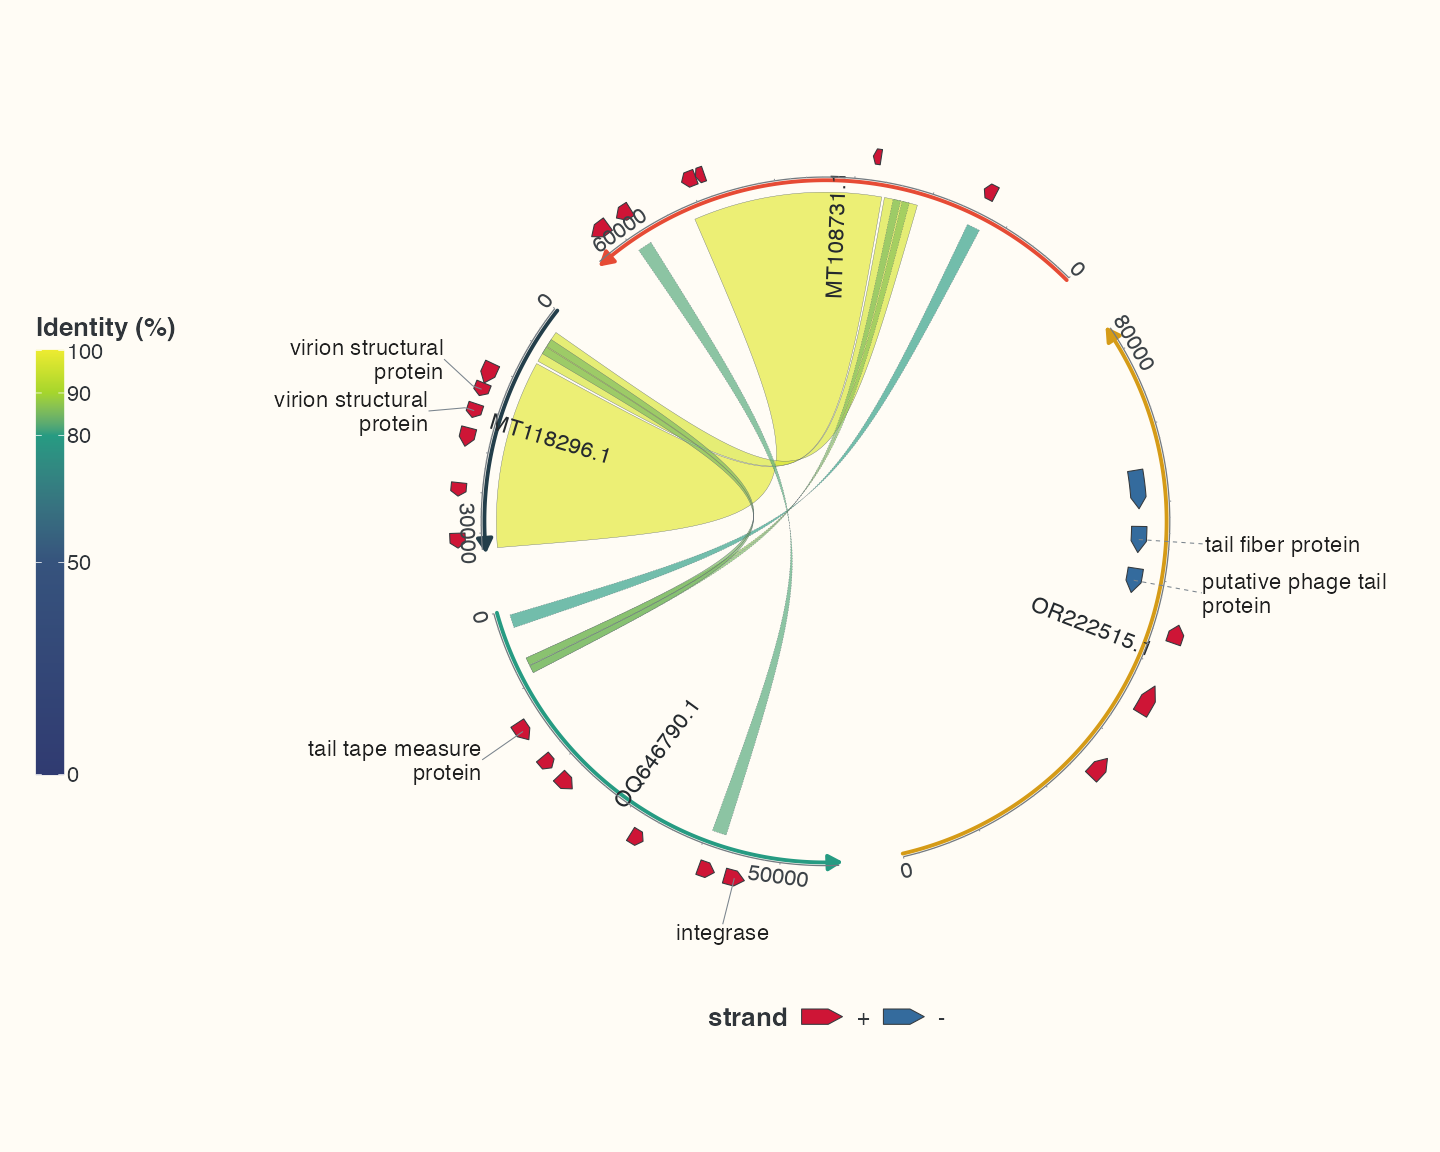
先读序列名称,再读真实链方向的注释箭头及区间连接。区间连接表达已有比对区间 和映射的相似度,连接交叉本身不构成重排证据。选定注释与更宽的比对区间分开阅读。 科学解释涉及显示子集之外的注释时,应使用完整输入表。
4. 在线性视图检查全部注释
代码
p_real_linear <- ggchord(seq_real, real_filtered$data, validate = "none") +
  geom_link_ribbon(fill = "#6BAFA6", alpha = .45) +
  geom_seq() +
  geom_seq_label(size = 4) +
  geom_feature(data = feature_real, feature_fill = "#CE1536", show.legend = FALSE, position = position_strand(.18)) +
  geom_seq_scale(length = 10000) +
  coord_collinear() +
  doc_axis() +
  scale_seq_colour_manual(values = seq_palette) +
  doc_theme
p_real_linear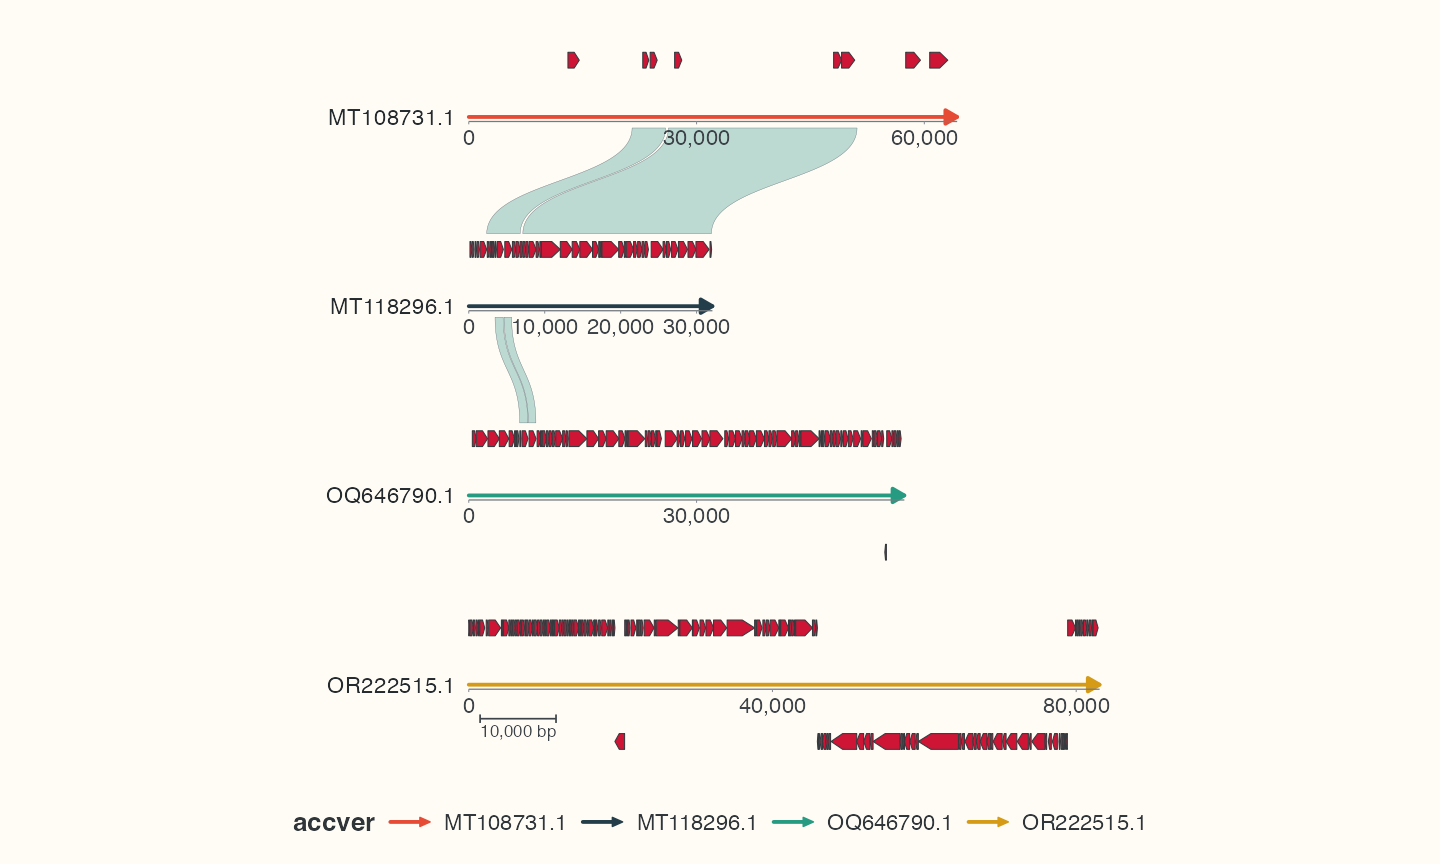
这张图绘制全部导入注释。区间连接默认只连接相邻显示序列,保留所有比较需要显式 图层设置。bp 参照条属于共线性坐标。裁剪、源坐标轴与独立窗口见局部视图, 按图集明确尺寸预览保存见输出。
5. 随图保留证据
教学输入包包含未改写的 FASTA/GFF3/BLAST、SHA256 清单和共享示例脚本。 绘图清单记录代码 hash、PNG 设备、宽高和 dpi。accession 名称标识来源记录, 图片不替代原始注释或比对证据。
先选列,再传入函数
*_source 对象保留原字段与来源;seq_real 只有两列,feature_real 只保留几何、 类型和注释文字,link_real 因为本例实际筛选和映射相似度,才额外保留 pident 和已报告的 length。这里使用标准 12 列转换文件,不要求历史 17 列布局。 随包基因示例将真实链保存在 source_strand;简短例子恢复该方向后,只选四列传入 基因图层。格式和单位的区别见比对输入教程。
完成后检查
检查序列 ID 在三张表中一致,查看筛选报告,再确认图例表达相似度与链方向。全长概览用于定位;若要研究具体 CDS,请继续聚焦邻域。
保存本页结果
在工作目录中保存刚刚创建的图;预览时使用相同宽高。
代码
ggsave("phage-comparison.png", p_real_chord, width = 10, height = 8, units = "in", dpi = 144)