章节与参考
模块二 · 单序列圆图 · 第 8 节,共 12 节
2.7 识别引物、弧线与文字
先识别真实 DNA 上的结合范围,再决定弧线与文字的显示位置。计算匹配不是湿实验验证,目录中的方向提示也不能代替目标序列上的实际结合链。
1 目录、搜索与实际输入
本页独立读取 pUC19,并保留 universal 目录精确搜索的前三条命中。每条结果保留引物名称、序列、一基闭区间、链、匹配方法与唯一性等字段。完整搜索后再取子集用于清楚展示;不要据此推断其他位点不存在。
R · 示例代码
finish_primers <- head(find_primer_bindings(finish_dna, set = "universal"), 3)| name | start | end | strand | match_type |
|---|---|---|---|---|
| M13/pUC Reverse | 478 | 500 | - | exact |
| M13 Reverse | 465 | 481 | - | exact |
| M13/pUC Forward | 364 | 386 | + | exact |
2 弧线的位置与宽度
between 是默认骨架中线;outside/inside 用 arc_offset(默认 0.045)沿局部法线移开。between/outside/inside 三种位置对照只改 side;加宽示例回到 between,只把 arc_linewidth 从 0.026 增到 0.05。这个宽度是局部几何参数,不能按 bp 或普通文字字号解释。
R · 示例代码
p_compareprimerbetween <- finish_recognition_base +
  geom_primer(data = finish_primers, side = "between")
view_ggchord(p_compareprimerbetween, width = 9, height = 8, units = "in")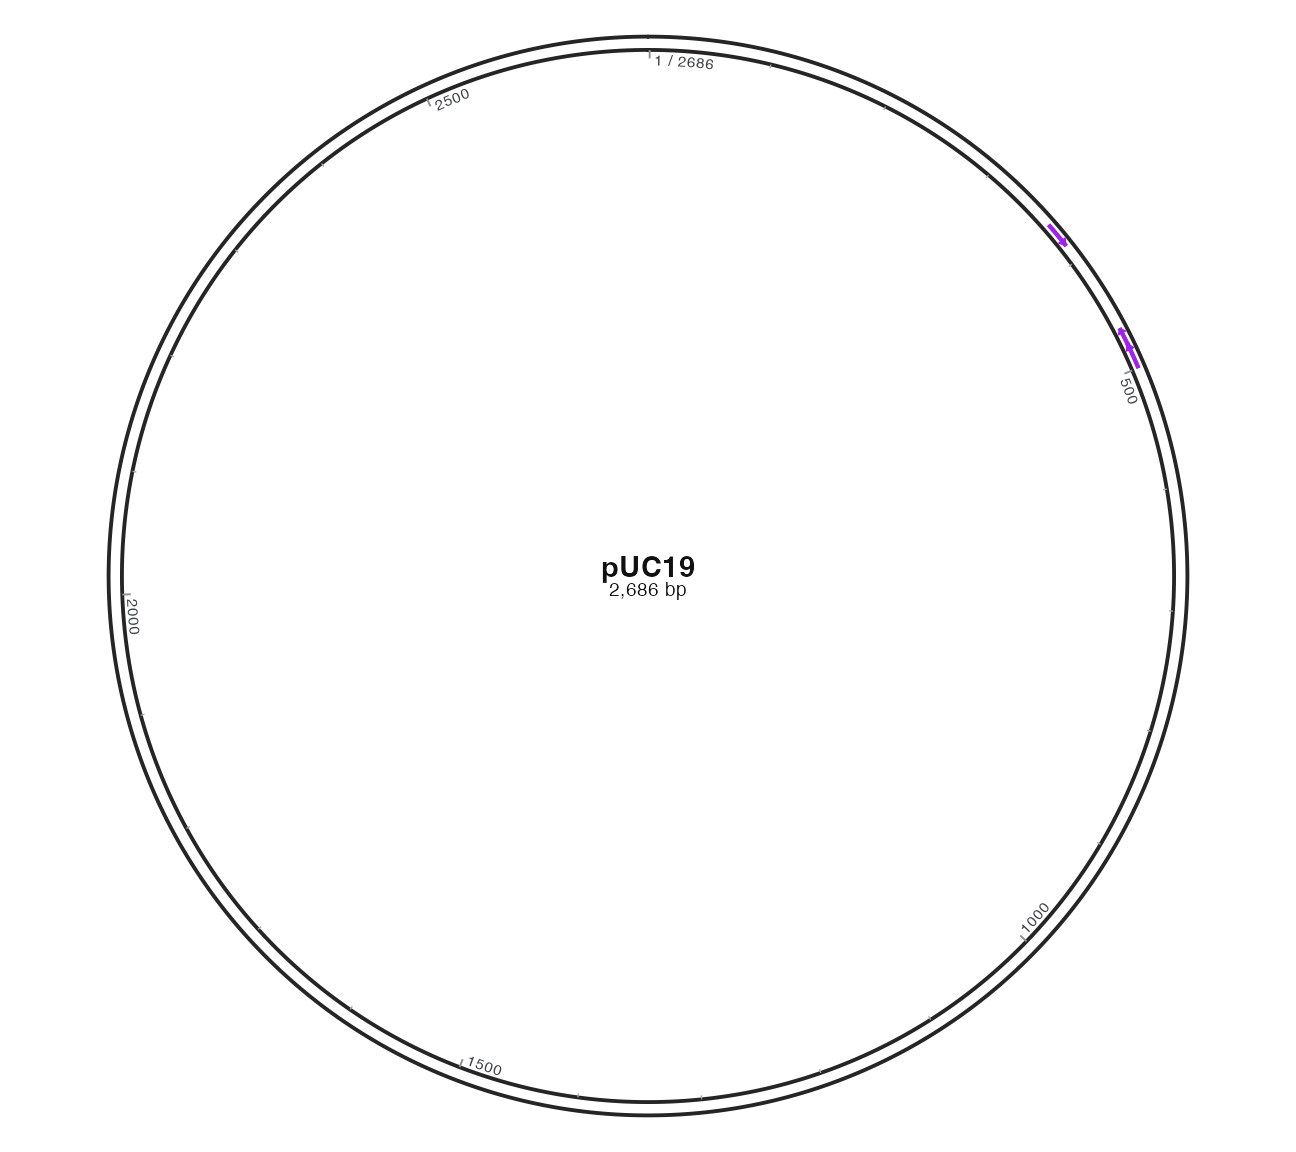
R · 示例代码
p_compareprimeroutside <- finish_recognition_base +
  geom_primer(data = finish_primers, side = "outside")
view_ggchord(p_compareprimeroutside, width = 9, height = 8, units = "in")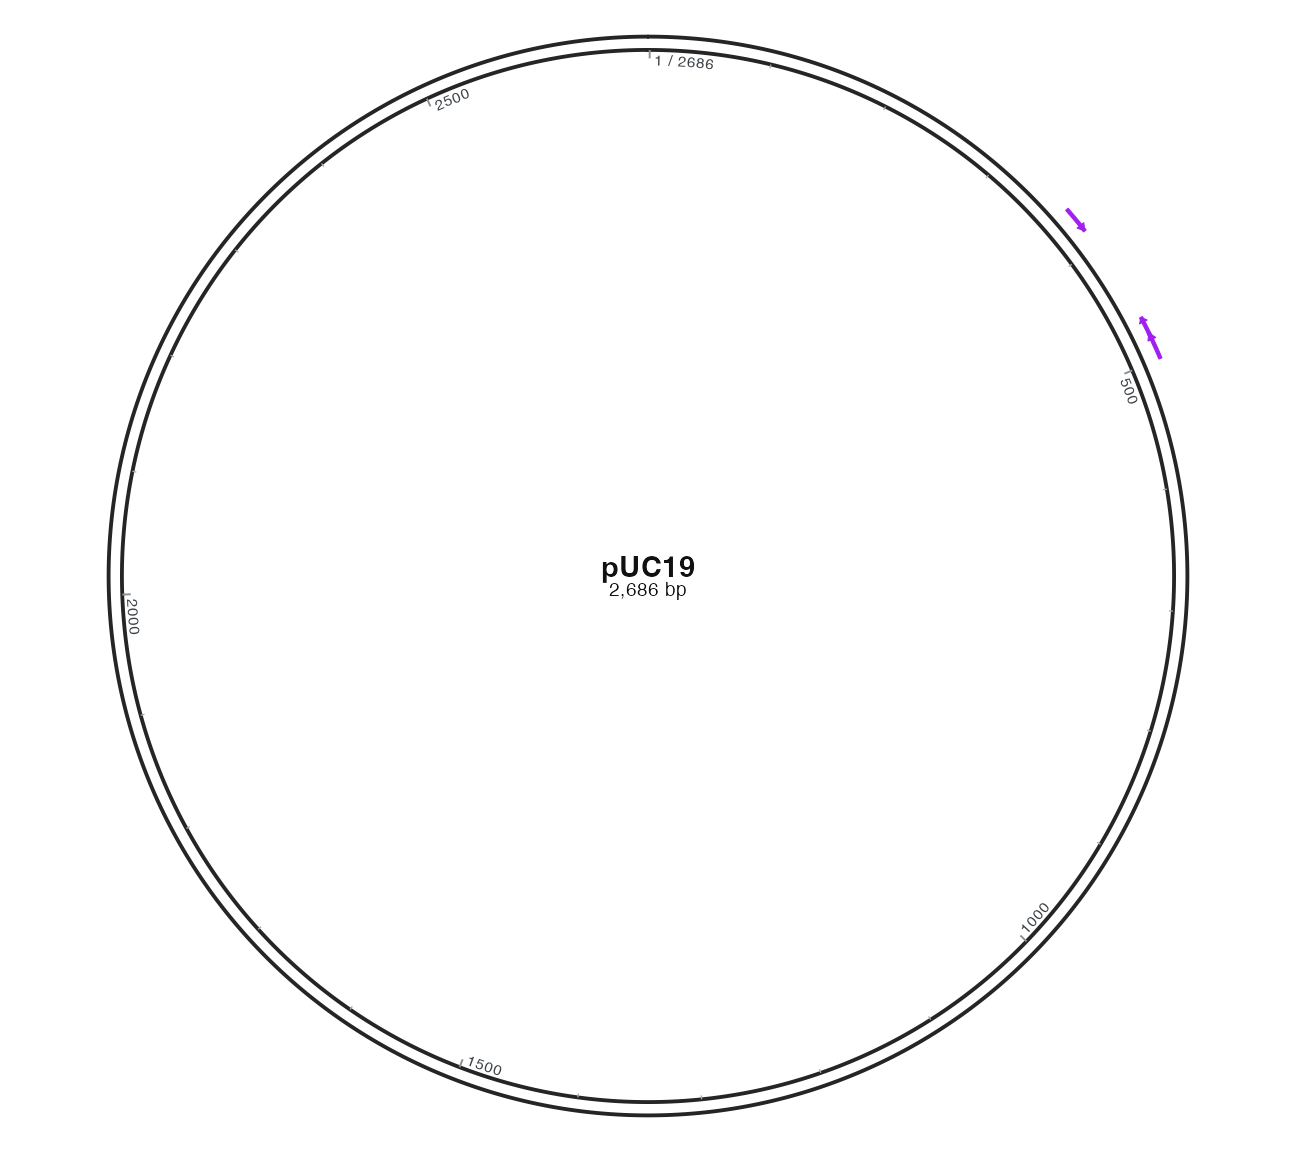
与 outside 图相比,只把 arc_offset 从 0.045 改为 0.09:
R · 示例代码
p_compareprimeroffset <- finish_recognition_base +
  geom_primer(data = finish_primers, side = "outside", arc_offset = 0.09)
view_ggchord(p_compareprimeroffset, width = 9, height = 8, units = "in")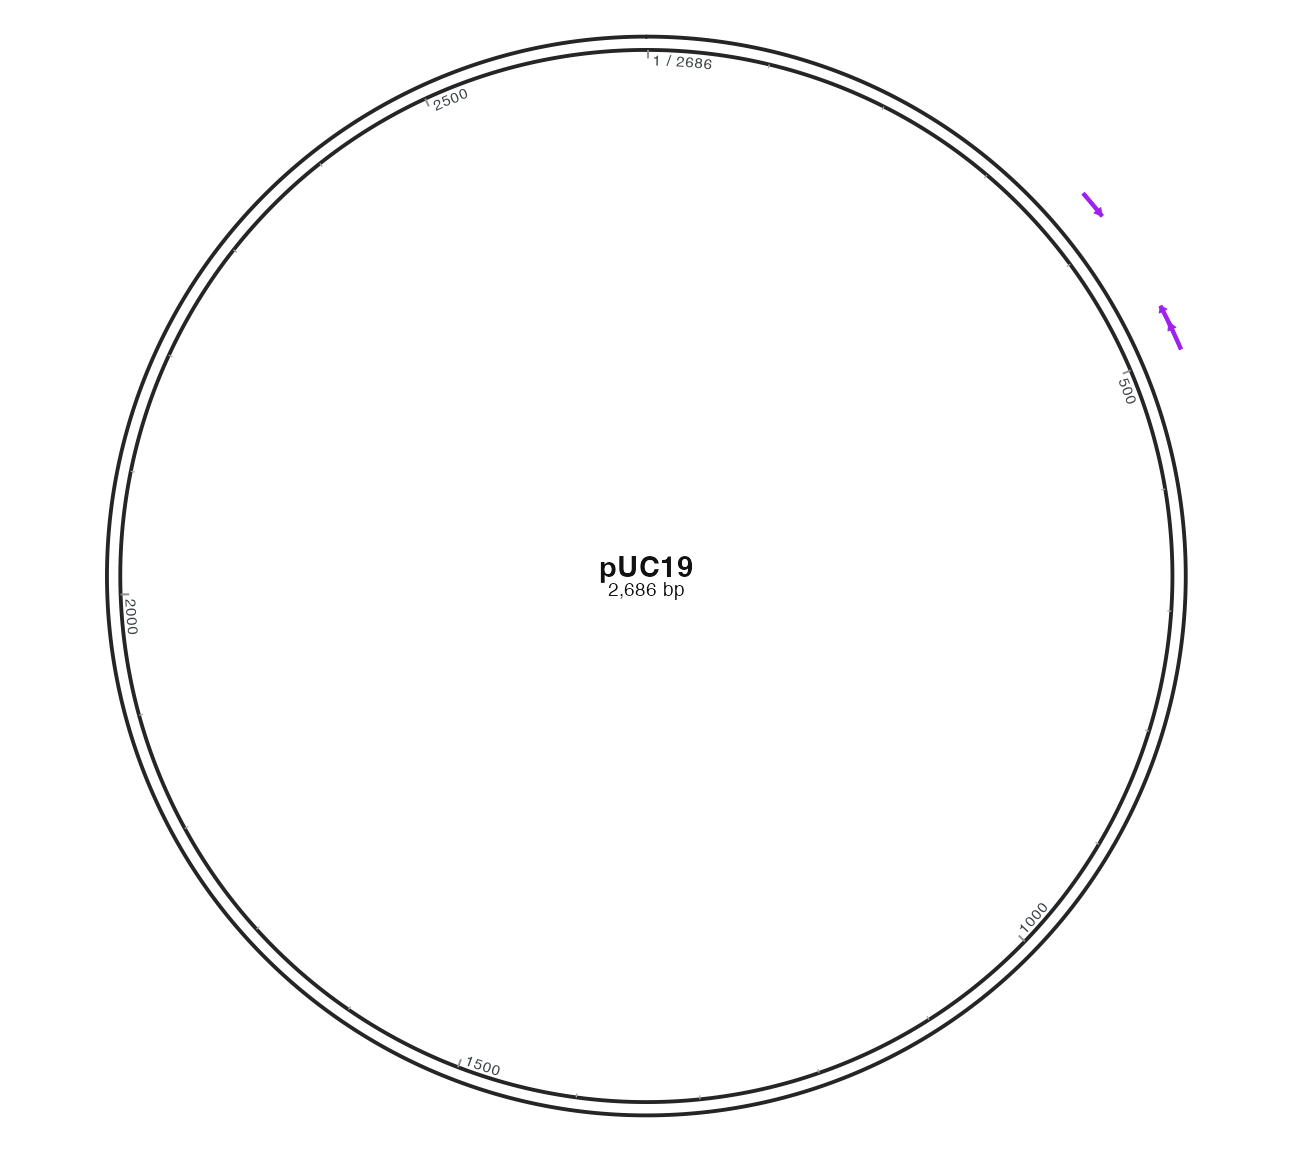
R · 示例代码
p_compareprimerinside <- finish_recognition_base +
  geom_primer(data = finish_primers, side = "inside")
view_ggchord(p_compareprimerinside, width = 9, height = 8, units = "in")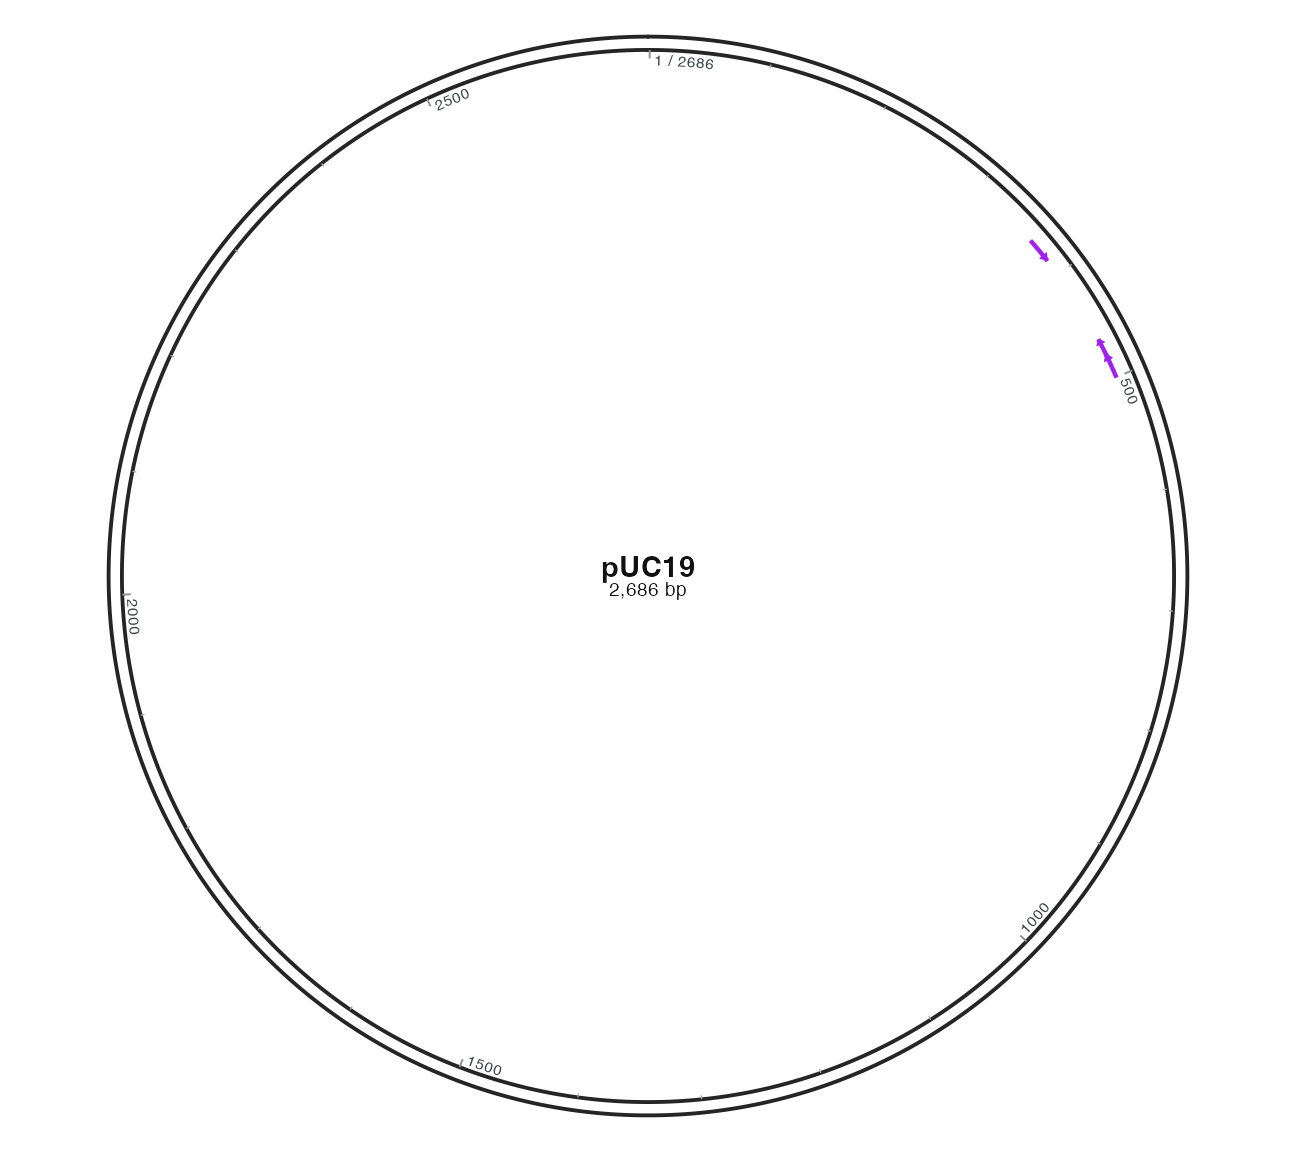
R · 示例代码
p_compareprimerwidth <- finish_recognition_base +
  geom_primer(data = finish_primers, side = "between", arc_linewidth = 0.05)
view_ggchord(p_compareprimerwidth, width = 9, height = 8, units = "in")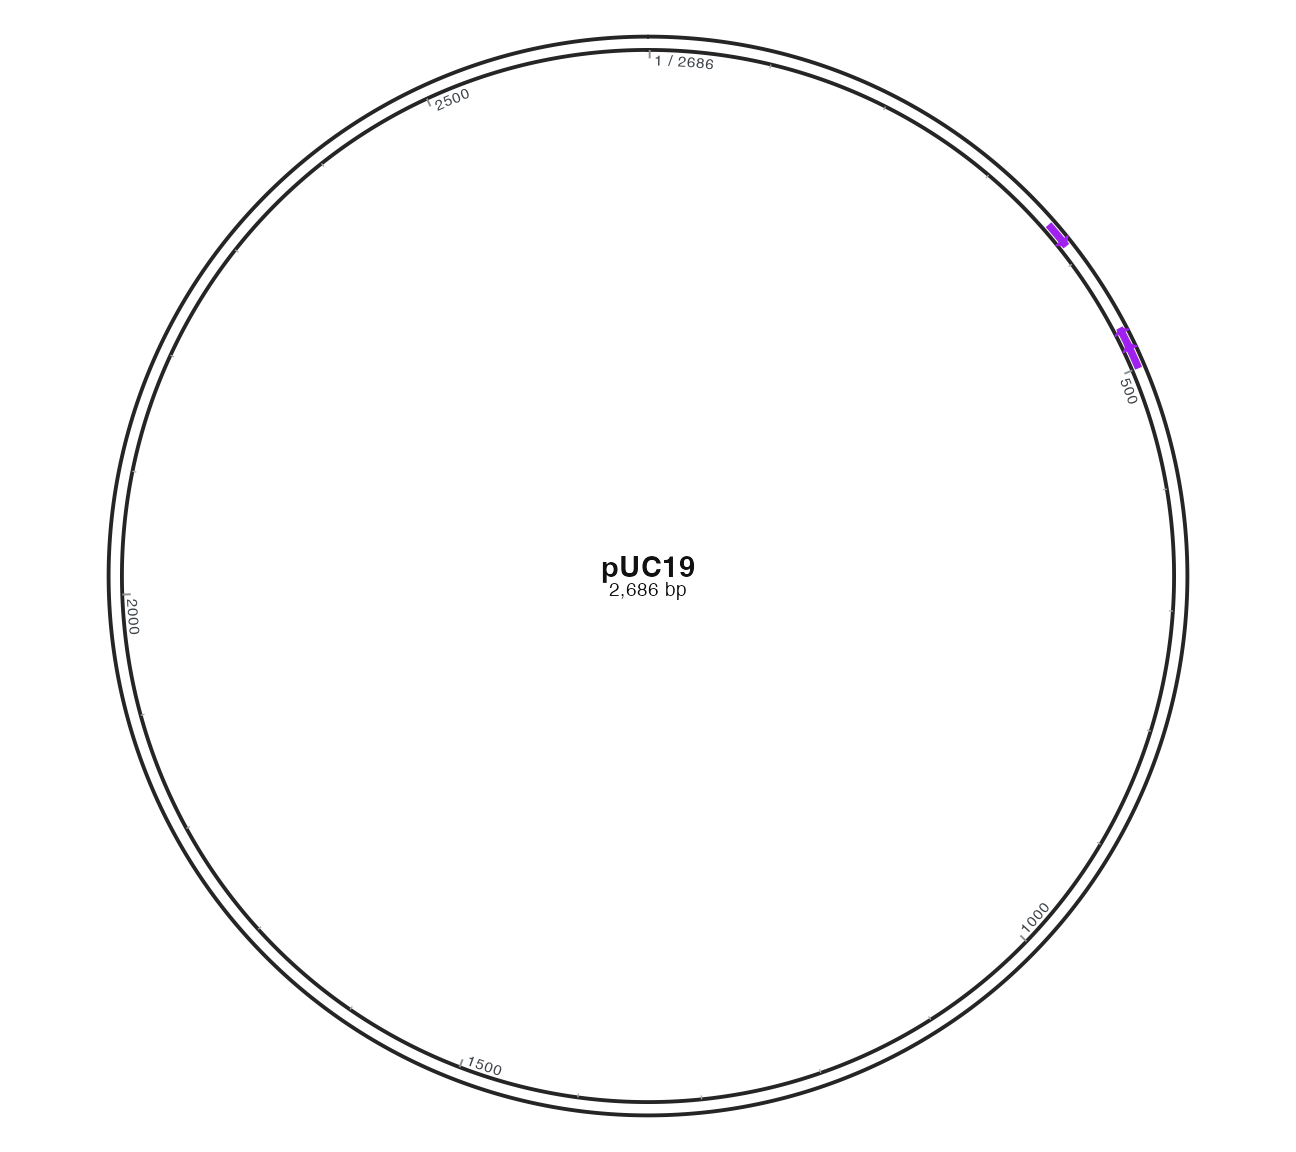
3 引物文字、位置范围与侧向
文字默认 outside 且 show_location=TRUE;引线从方向弧的 3′ 端出发。与默认图比较时,只隐藏位置范围,或者只改为 inside。隐藏范围文字不会缩短实际结合区间。内侧文字可能压到其他特征;默认 max_overlaps=Inf 不保证跨层无重叠。
R · 示例代码
p_compareprimerlabel <- finish_recognition_base +
  geom_primer(data = finish_primers) +
  geom_primer_label_repel(data = finish_primers, side = "outside")
view_ggchord(p_compareprimerlabel, width = 9, height = 8, units = "in")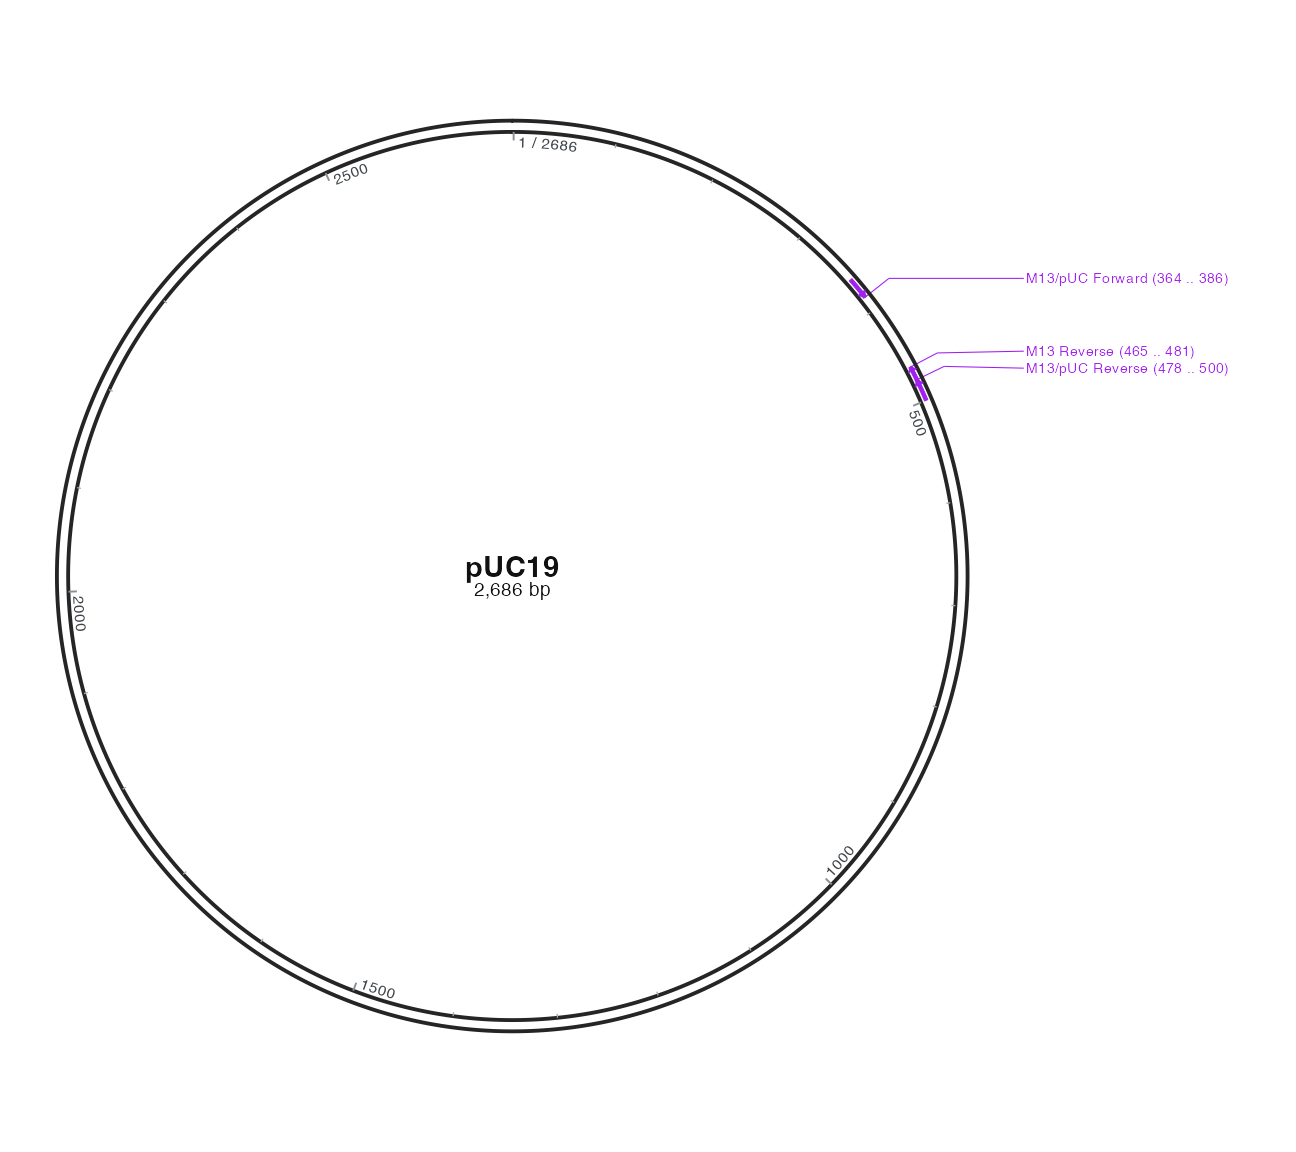
R · 示例代码
p_compareprimernolocation <- finish_recognition_base +
  geom_primer(data = finish_primers) +
  geom_primer_label_repel(data = finish_primers, side = "outside", show_location = FALSE)
view_ggchord(p_compareprimernolocation, width = 9, height = 8, units = "in")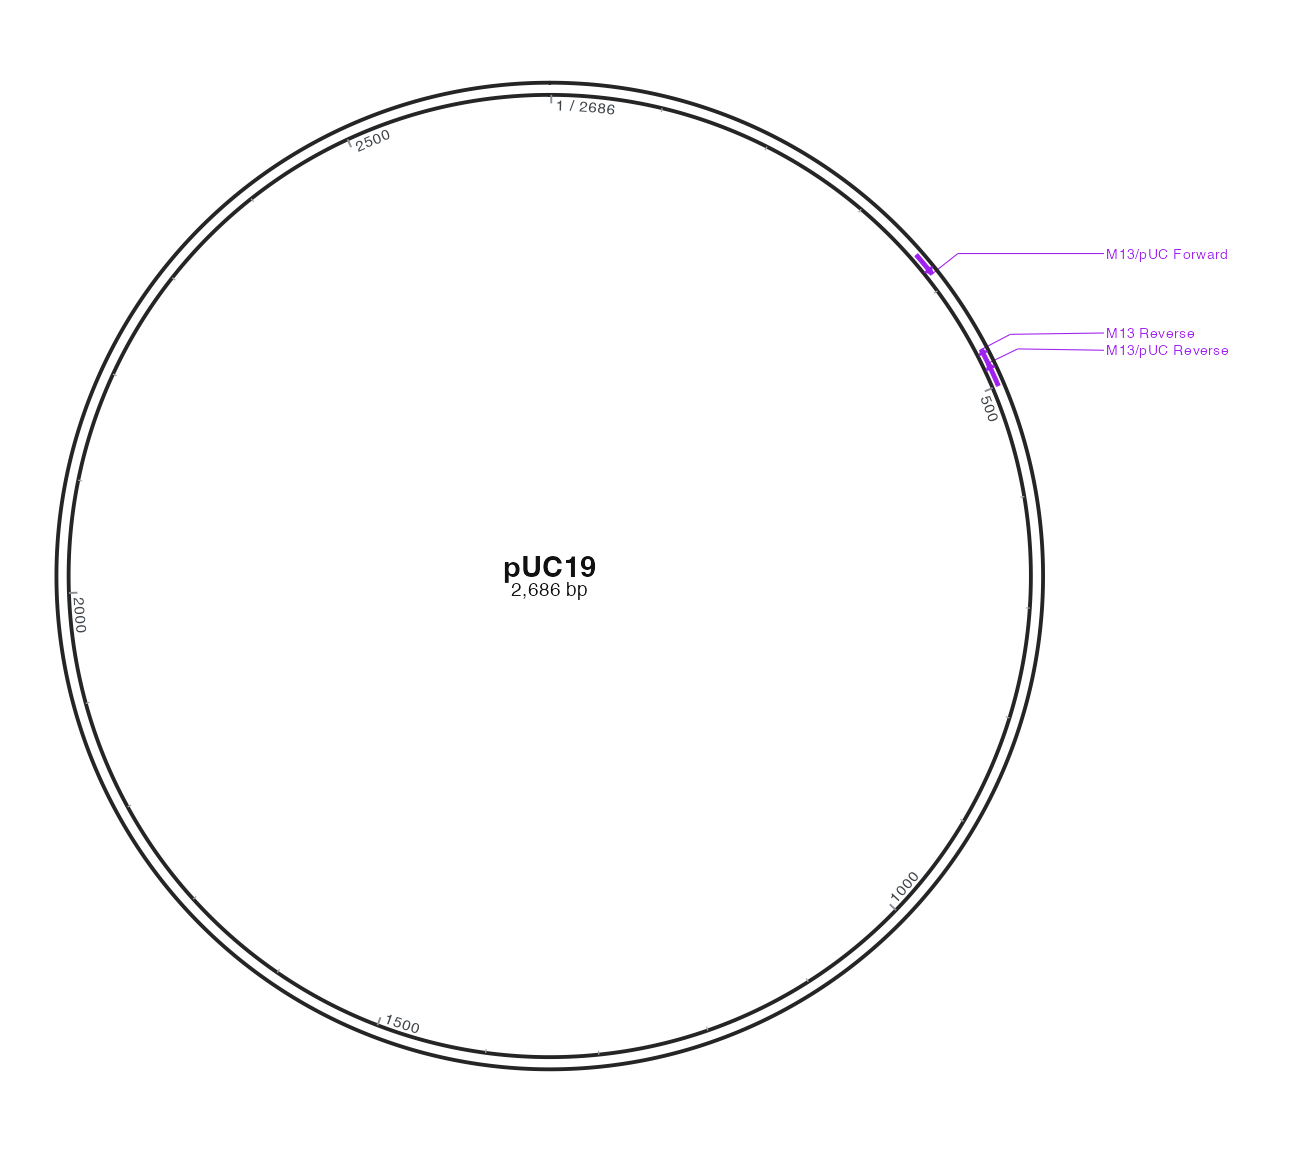
R · 示例代码
p_compareprimerlabelinside <- finish_recognition_base +
  geom_primer(data = finish_primers) +
  geom_primer_label_repel(data = finish_primers, side = "inside")
view_ggchord(p_compareprimerlabelinside, width = 9, height = 8, units = "in")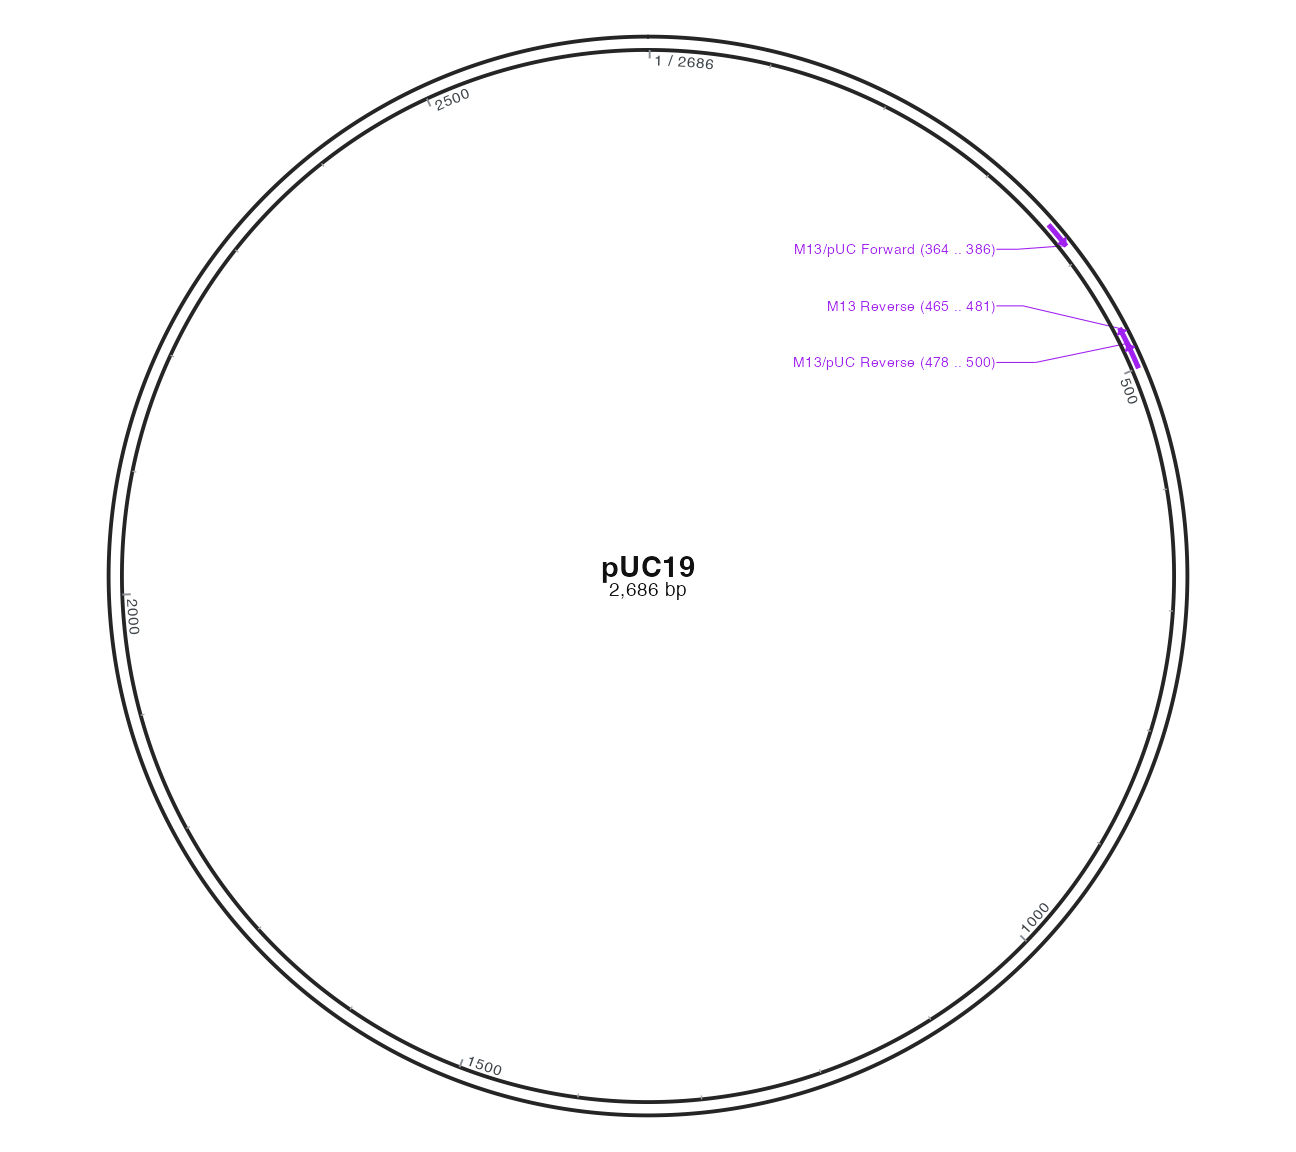
4 搜索与绘制的选择边界
primer_catalog(set="all", aliases=FALSE) 返回去重寡核苷酸表;universal 选择常见子集,aliases=TRUE 查看同序列的来源别名。find_primer_bindings() 在 DNA 上计算命中;环形搜索检查跨原点,线性输入应设 circular=FALSE。three_prime 模式的精确后缀匹配不是通用错配热力学模型。Wallace 温度是启发式组成估计。
geom_primer 默认 colour=#A020F0、side=between、arc_offset=0.045、arc_linewidth=0.026。文字默认 side=outside、show_location=TRUE、max_overlaps=Inf。两者的数据均须来自同一目标序列;不能只改 accver 把一个模板的命中搬到另一条 DNA。建议用单序列圆图;aa 数据拒绝核酸专属层。
5 动手与自己的引物
先只改变 arc_offset,再回到默认将 show_location 关闭。自定义寡核苷酸须提供真实序列与名称,先查看匹配字段,再决定显示哪些命中。全文 API 与参数默认见参数图谱。下一步是酶切搜索与显示和完整质粒流程。