章节与参考
数据与工作流 · 第 3 节,共 12 节
6.2 读取区间与配对区间
准备数据与配置(展开)
先解压真实输入包,工作目录须含 examples/;每节单列可选依赖。
1 BED 和 PAF:坐标只转换一次
BED 的起点从 0 开始,终点不包含在区间内。下例读入一条 pUC19 复制起点记录,比较读入前后的坐标。
R · 示例代码
bed_path <- tempfile(fileext = ".bed")
writeLines("pUC19\t866\t1455", bed_path)
bed_features <- read_bed(bed_path)
unlink(bed_path)
bed_features| accver | start | end | strand | directionality | chromStart | chromEnd | .source_line |
|---|---|---|---|---|---|---|---|
| pUC19 | 867 | 1455 | . | none | 866 | 1455 | 1 |
PAF 提供两端全长和区间。先选出 mapq ≥ 30 的比对,再由两端长度生成骨架表。
R · 示例代码
paf_source <- read_paf("examples/format-inputs/emales-pair.paf")
paf_links <- filter(paf_source, !is.na(mapq), mapq >= 30)
paf_seqs <- bind_rows(
  transmute(paf_source, accver = qaccver, length = qlen),
  transmute(paf_source, accver = saccver, length = slen)
) |> distinct()
head(select(paf_links, qaccver, qstart, qend, saccver, sstart, send), 3)| qaccver | qstart | qend | saccver | sstart | send |
|---|---|---|---|---|---|
| BVI_023A | 1728 | 11139 | Cflag_017A | 17357 | 7863 |
| BVI_023A | 15258 | 15450 | Cflag_017A | 4320 | 4129 |
R · 示例代码
p_paf <- ggchord(paf_seqs) +
  geom_seq() +
  geom_seq_label() +
  geom_link_ribbon(data = paf_links) +
  coord_collinear()
view_ggchord(p_paf, width = 10, height = 5, units = "in")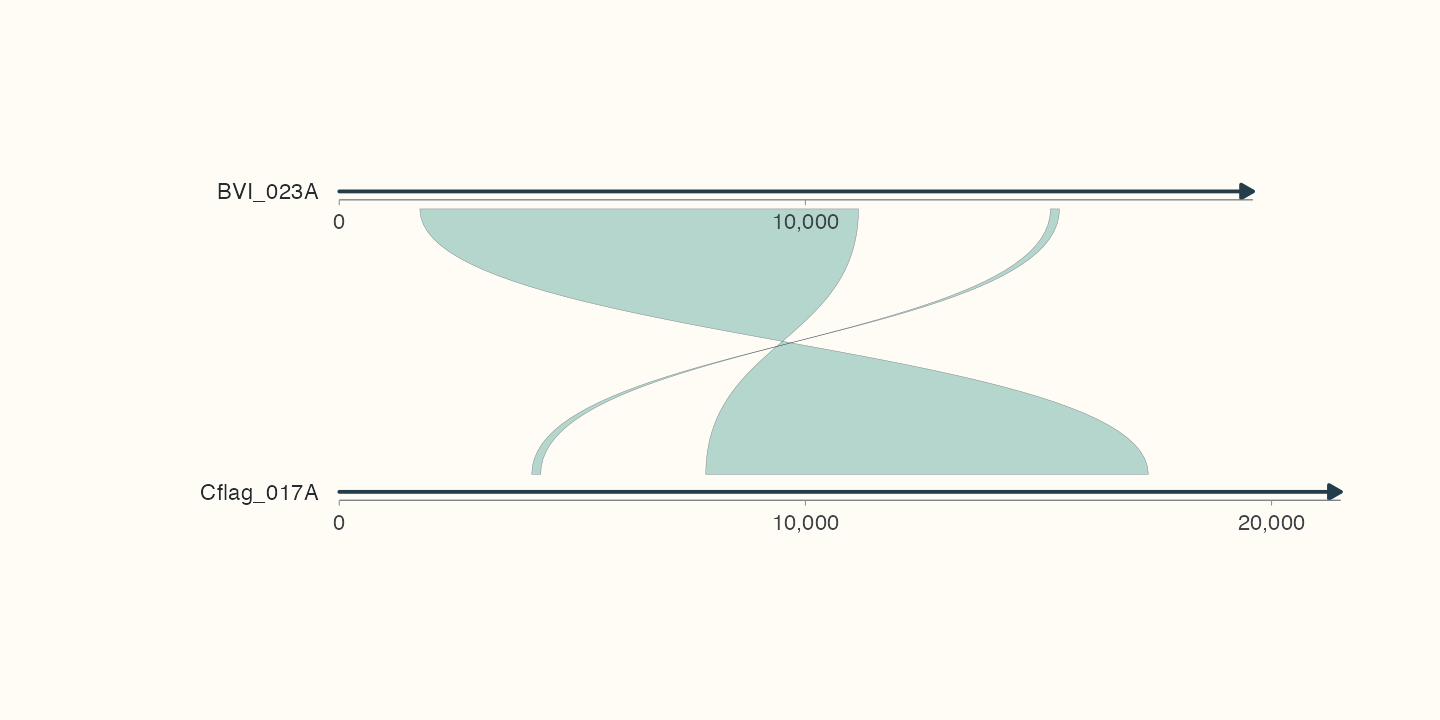
反向比对用递减的 subject 端点表达。绘图使用读取器转换后的坐标。
2 可选的区间对象
第一段把序列 a 上的 10–30 bp 转成特征表。第二段把 a 上的 10–30 bp 与 b 上的 40–60 bp 连成一条记录。GRanges 表示一个区间,GInteractions 表示一对区间。先安装 GenomicRanges 和 InteractionSet,完整序列长度由 seqlengths 提供。
| accver | start | end | strand | .source_row | directionality | source_strand |
|---|---|---|---|---|---|---|
| a | 10 | 30 | + | 1 | forward | + |
| qaccver | saccver | qstart | qend | sstart | send | qstrand | sstrand | .source_row | .query_anchor | .subject_anchor | orientation_known | direction | query_directionality | subject_directionality |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| a | b | 10 | 30 | 40 | 60 | * | * | 1 | 1 | 2 | FALSE | None | none | none |
3 BED双端区间
read_bedpe()读取六个必填的制表符分隔字段,以及可选name、score、两条链和额外元数据。第一端保持query、第二端保持subject;score保留为字符串,不推断Identity或测序支持度。格式依据BEDPE说明。
下面将随包已观测比对的区间转写为BEDPE,用于坐标往返验证,不将它们当作配对测序证据。六列输入没有链证据,因此导入后的锚点链和相对方向保持未知。有真实链信息时才提供对应列,不由坐标升序猜测链。
R · 示例代码
data(ribbon_data_example)
paired_rows <- ribbon_data_example |>
  transmute(
    chrom1 = qaccver, start1 = pmin(qstart, qend) - 1, end1 = pmax(qstart, qend),
    chrom2 = saccver, start2 = pmin(sstart, send) - 1, end2 = pmax(sstart, send)
  )
paired_file <- tempfile(fileext = ".bedpe")
write.table(paired_rows, paired_file,
  sep = "\t", quote = FALSE, row.names = FALSE, col.names = FALSE
)
paired_links <- read_bedpe(paired_file)
unlink(paired_file)
paired_links |>
select(qaccver, saccver, qstart, qend, sstart, send, q_mapped, s_mapped)负链锚点采用降序canonical端点,与配对区间适配器一致;同时保留原始start/end和链字段。name不视为唯一ID。额外列在bedpe_extra中保留,按column_11起命名。未知染色体(.)或边界(-1)默认报错;显式unmapped="keep"为审计保留不完整行,适配或绘图前须筛选q_mapped & s_mapped。非法已知坐标和零宽区间始终报错。区间Ribbon没有Identity时,显式设置固定填充,不制造pident。