章节与参考
模块四 · 多视图组合 · 第 5 节,共 6 节
4.4 局部放大与字符细节
准备数据与配置(展开)
R · 示例代码
library(dplyr)
fusion_hsp <- sequence_detail_example$paf
fusion_seqs <- bind_rows(
fusion_hsp |> transmute(accver = qaccver, length = qlen),
fusion_hsp |> transmute(accver = saccver, length = slen)
) |>
distinct()
fusion_colours <- setNames(c("#0072B2", "#D55E00"), fusion_seqs$accver)
fusion_links <- fusion_hsp |>
filter(length >= 900, pident >= 85)
fusion_events <- fusion_hsp |>
transmute(accver = qaccver, pos = qstart)R · 示例代码
fusion_center <- ggchord(fusion_seqs |> slice(1)) +
geom_seq(aes(seq_colour = accver), show.legend = FALSE) +
geom_track(
data = fusion_events, geom = "bar", stat = "bin", binwidth = 2000,
boundary = 1, closed = "left", bounds = "clip",
track = position_track("hsp-start-count", width = unit(6, "mm"))
) +
scale_track_value_continuous("hsp-start-count", name = NULL, breaks = c(0, 5)) +
scale_seq_colour_manual(values = fusion_colours) +
coord_circular()R · 示例代码
fusion_linear <- ggchord(fusion_seqs, fusion_hsp) +
geom_seq(show.legend = FALSE) +
geom_link_ribbon(show.legend = FALSE) +
geom_seq_label() +
scale_seq_colour_manual(values = fusion_colours) +
coord_collinear()
fusion_vertical <- fusion_linear +
coord_collinear(seq_axis = "vertical")R · 示例代码
p_fusionview <- ggchord_fusion(fusion_center, layout = "adaptive") +
fusion_panel(fusion_vertical, id = "detail", side = "right") +
fusion_ribbon(fusion_links, qpanel = "center", spanel = "detail", alpha = 0.28)1 源区间与独立局部细节
magnify_ggchord() 组合一张 Circular/Chord/Collinear 源图和显式构建的 Collinear 细节图。源区间是生物学数据,不是图片像素中的矩形;同一区间须在两个面板完整可见。两个面板都按最终设备尺寸重建,不拉伸截图。
下例选择 pETDuet-1 的原始位置 101–1900,共 1800 bp。5404→2 的跨原点注释与该窗口没有交集;进入线性聚焦前显式排除,不能用 min/max 把它误画成长特征。细节保留 10 条注释,并按明确规则给 CDS/复制起点子集加标签。反转细节的显示方向不改变源坐标或生物学链。
R · 示例代码
plasmid <- plasmid_example_pETDuet_1
annotations <- find_common_features(plasmid)
selected_region <- data.frame(accver = plasmid$accver, start = 101, end = 1900)
local_source <- focus_ggchord_data(
plasmid,
feature_data = annotations |> filter(start <= end),
loci = selected_region
)
whole_plasmid <- ggchord(plasmid, feature_data = annotations) +
geom_seq(show.legend = FALSE) +
geom_feature(position = position_plasmid(), show.legend = FALSE) +
geom_seq_center_label() +
coord_circular(rotation = -30)
local_labels <- local_source$feature_data |>
filter(type %in% c("CDS", "rep_origin"), anno != "ATG")
local_detail <- ggchord(
local_source$seq_data, feature_data = local_source$feature_data
) +
geom_seq(seq_orientation = -1, show.legend = FALSE) +
geom_feature(show.legend = FALSE) +
geom_feature_label(
data = local_labels, label_orientation = "horizontal",
label_overlap = "allow", colour = "#202020", size = 3
) +
coord_collinear(seq_axis = "vertical") +
scale_seq_position_continuous(coordinates = "source")
focused_view <- magnify_ggchord(whole_plasmid, selected_region, local_detail)
focused_view
focus_geometry <- export_ggchord_fusion(focused_view, width = 12, height = 8)
focus_geometry$focus_regions
focus_geometry$leaders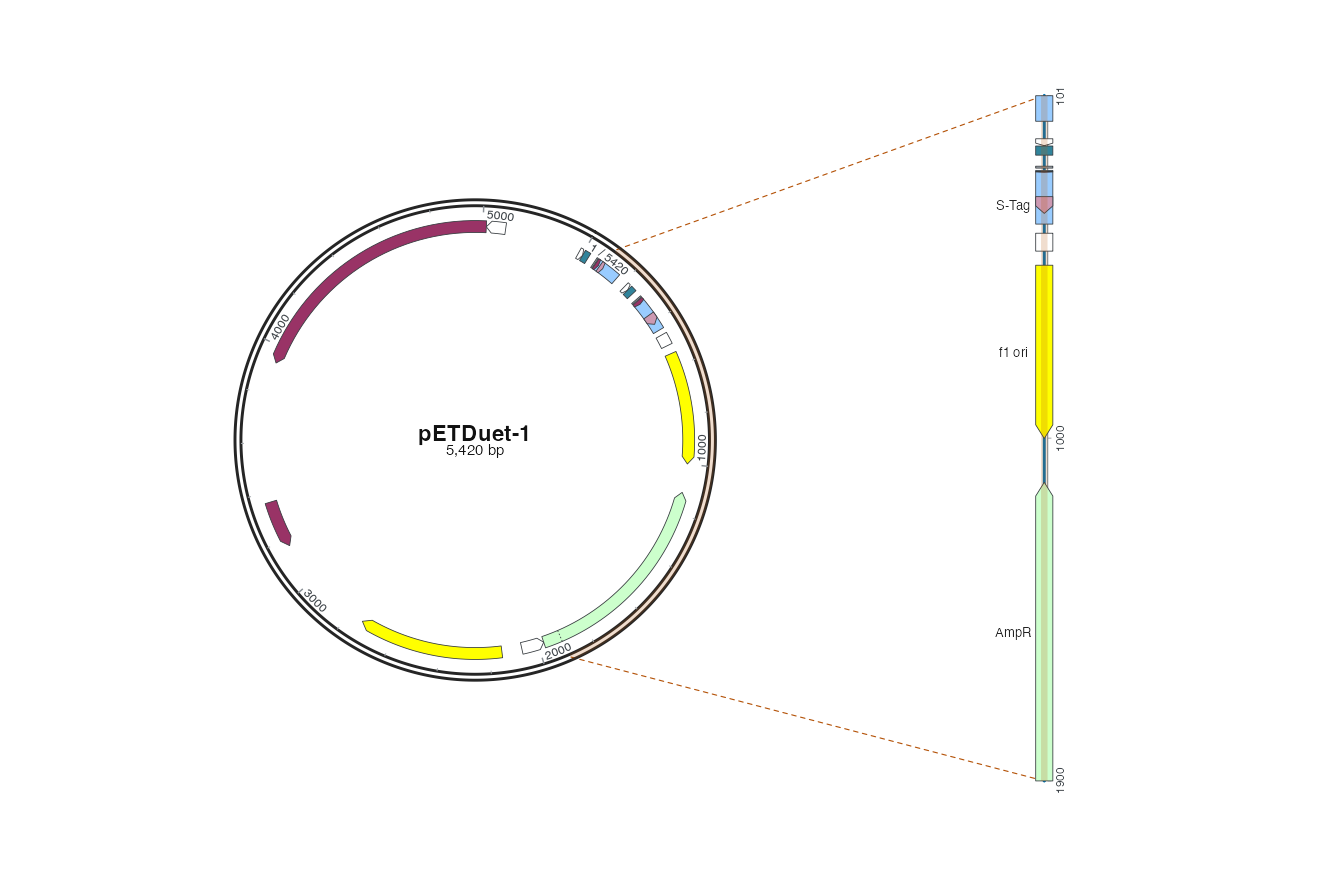
用普通 ggsave() 指定物理尺寸保存,例如 12×8 英寸;view_ggchord() 使用同一渲染器。center_size、detail_size 是容器比例,highlight_width 则以物理 mm 计。细节方位和显示方向会影响引线是否交叉,这里不承诺全局避让。connector = "none" 只保留高亮。
1.1 原图框与真实放大范围
默认源图框使用 region 的精确横向源坐标;细节图按同一区间显式构造。框高由 highlight_width 以物理毫米独立控制,纵向排版不要求与细节图相同。需要只改框时提供 frame_region:每个 region 行对应一行 start/end,顺序一致;真实 region、细节图数据和实测放大倍率保持原值。框必须在相同源实例中完整可见,跨原点自定义框先显式拆分。
R · 示例代码
source_frame <- selected_region |>
mutate(start = start - 20, end = end + 20)
framed_view <- magnify_ggchord(whole_plasmid, selected_region, local_detail,
frame_region = source_frame, highlight_width = 1.5)
export_ggchord_fusion(framed_view, width = 12, height = 7)$focus_regions |>
select(accver, start, end, frame_start, frame_end)上例的真实放大区间仍是101–1900;框改为81–1920。导出表中的 start/end 与 frame_start/frame_end 分别记录两者,focus_frame_region_data 单独保留原始框设置。字符面板使用无填充单元格描边,避免半透明高亮遮盖字母和残基底色。
虚线是装饰性的聚焦引线,与生物学 connections、relationship_data 分开导出;添加真实 fusion_ribbon() 仍须提供真实关系数据。focus_region_data 保留原始选区及任意元数据,focus_regions 记录解析出的实例、源原点和采样物理路径长度比。细节容器较小时,该比值可能小于 1,这不改变生物学长度。
细节图拥有自己的数据、标度、图层和统计。若使用 count/bin/coverage 轨道,请自行准备并说明局部或全局统计总体;组合器只记录 explicit_detail_plot,不会静默选择口径。它不复制任意源图层、不推断比对,也不接收未注册的 Cartesian 字符面板。当前使用一个有序区间;同一 accession 重复时显式指定 instance/detail_instance,跨原点选区按后文显式声明 wrap = TRUE。下节提供独立细节;后文进一步介绍显式嵌套与自由区域分配,实测障碍路由见后文。
2 保留真实 HSP 的成对源窗口
本例的 region 每行选择一个原始源区间,所有行共享一个显式细节面板。本例从四序列数据中选取一条真实 HSP 的两个端点窗口,基因方向和局部 HSP 均来自聚焦后的输入表。派生区域、前缘和装饰引线通过 region_row 对应输入行;任意原始元数据保留在 focus_region_data。
R · 示例代码
library(dplyr)
seqs <- seq_data_example |> select(accver, length)
features <- gene_data_example |> mutate(strand = source_strand, type = 'CDS')
hsp <- ribbon_data_example |> slice(1)
regions <- bind_rows(
transmute(hsp, accver = qaccver, start = pmin(qstart, qend), end = pmax(qstart, qend)),
transmute(hsp, accver = saccver, start = pmin(sstart, send), end = pmax(sstart, send))
)
local <- focus_ggchord_data(seqs, feature_data = features,
ribbon_data = hsp, loci = regions)
source <- ggchord(seqs, feature_data = features, ribbon_data = hsp) +
geom_seq(show.legend = FALSE) + geom_gene(show.legend = FALSE) +
geom_link_ribbon(show.legend = FALSE)
detail <- ggchord(local$seq_data, feature_data = local$feature_data,
ribbon_data = local$ribbon_data) + geom_seq(show.legend = FALSE) +
geom_gene(show.legend = FALSE) + geom_link_ribbon(show.legend = FALSE) + coord_collinear()
paired_detail <- magnify_ggchord(
source + coord_collinear(), regions, detail, side = "bottom"
)
paired_detail
export_ggchord_fusion(paired_detail, width = 12, height = 8)$focus_regions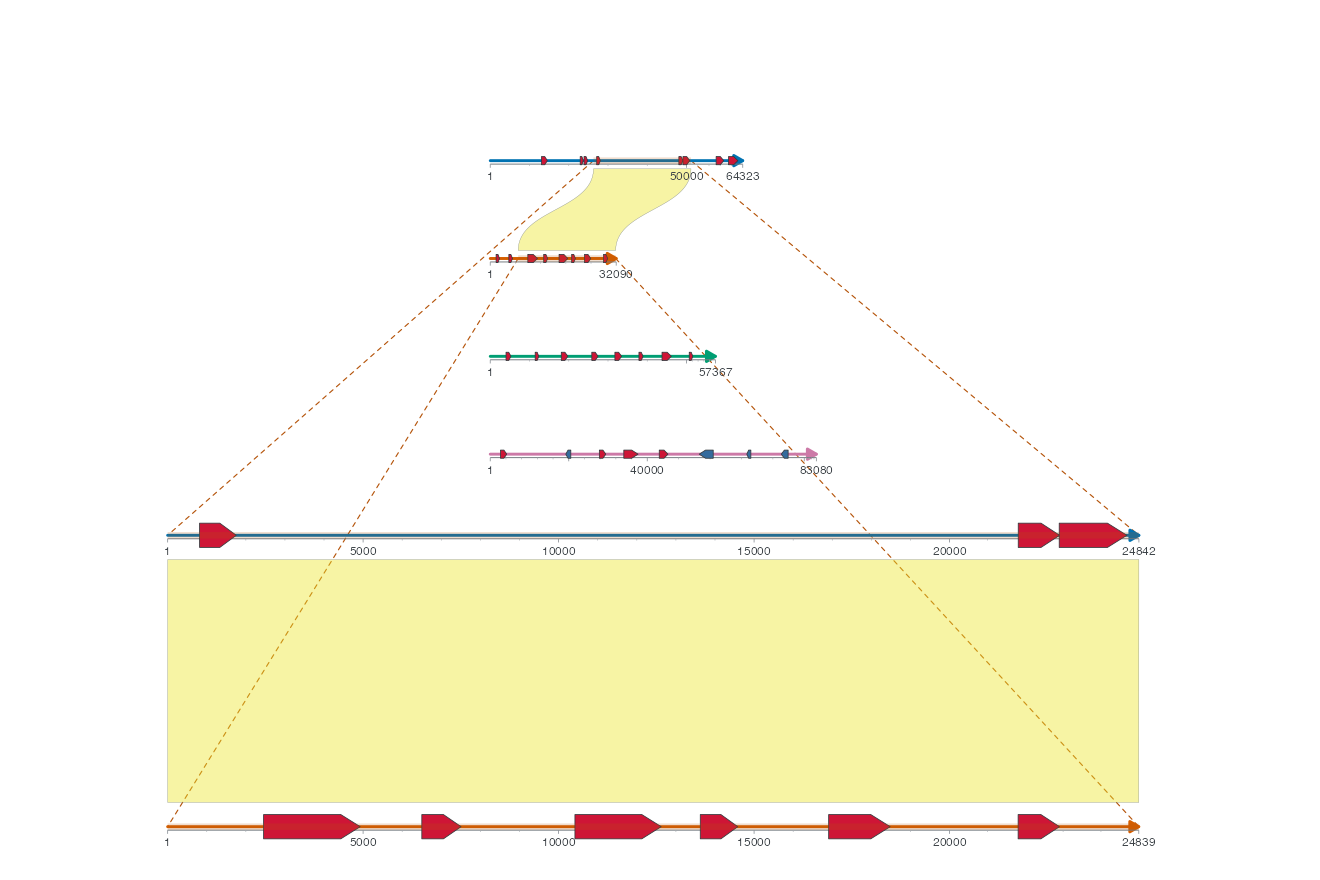
这仍然只有一个细节面板,不推断逐碱基比对。每个区间须在两个面板完整可见;实例选择按行独立解析。
3 独立细节面板
将一条真实 HSP 的两端分别绘为独立局部图。命名列表提供细节图,detail_panel 为每个源行选择目标,命名 side 向量指定不同侧边。每个面板拥有自己的数据和标度。
R · 示例代码
library(ggchord)
library(dplyr)
seqs <- seq_data_example |> select(accver, length)
hsp <- ribbon_data_example |> slice(1)
regions <- bind_rows(
transmute(hsp, accver = qaccver, start = pmin(qstart, qend),
end = pmax(qstart, qend), detail_panel = "query"),
transmute(hsp, accver = saccver, start = pmin(sstart, send),
end = pmax(sstart, send), detail_panel = "subject")
)
make_detail <- function(region) {
local <- focus_ggchord_data(seqs, loci = region)
ggchord(local$seq_data) +
geom_seq(show.legend = FALSE) +
coord_collinear(seq_axis = "vertical")
}
source <- ggchord(seqs, hsp) +
geom_seq(show.legend = FALSE) +
geom_link_ribbon(show.legend = FALSE)
details <- list(
query = make_detail(regions[1, ]),
subject = make_detail(regions[2, ])
)
multiple <- magnify_ggchord(
source, regions, details,
side = c(query = "left", subject = "right")
)
export_ggchord_fusion(multiple, width = 12, height = 8)$focus_regions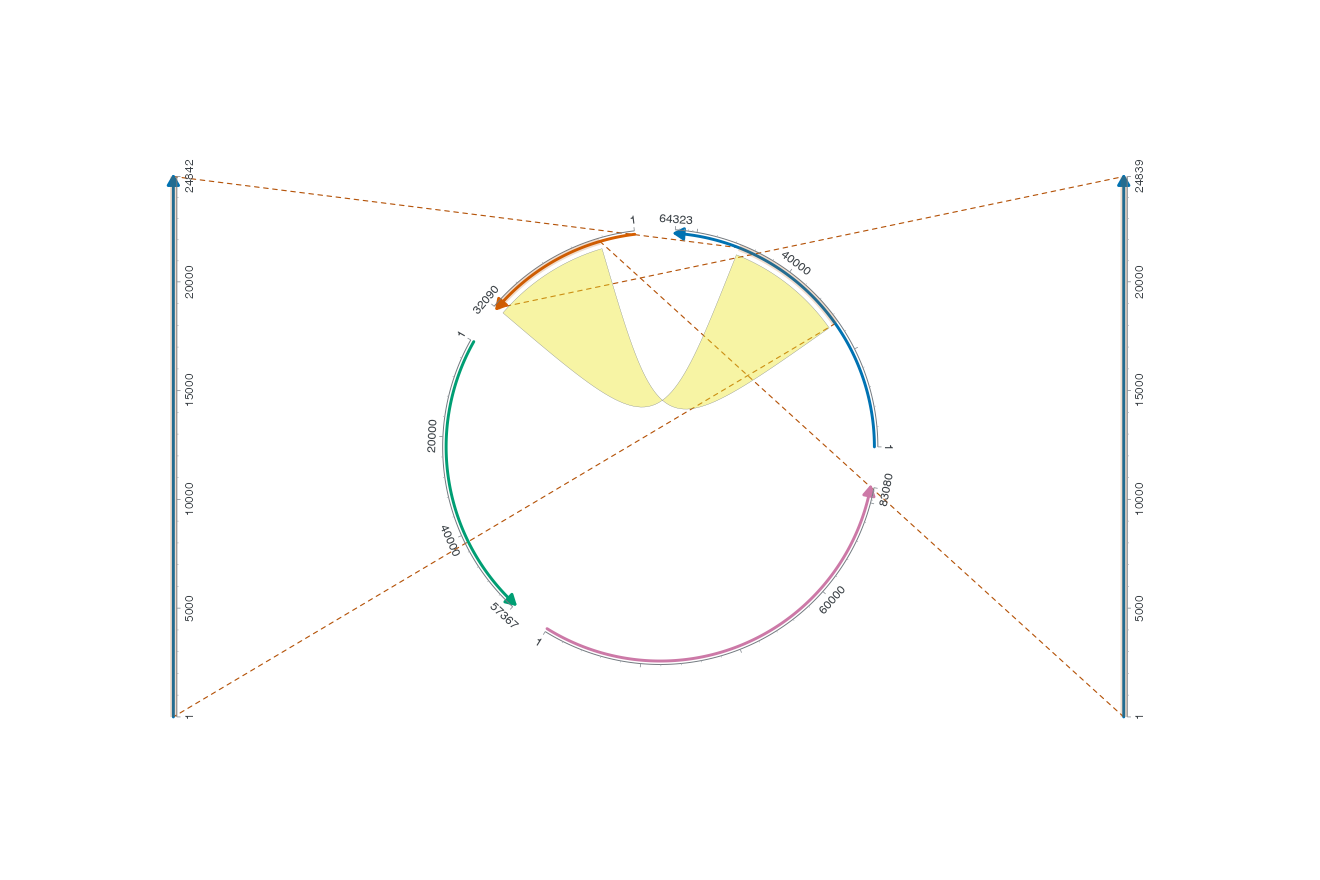
本例使用四侧命名细节,每侧一个,每个面板须有选区;缺失或未知目标会报错。 源/目标实例选择相互独立。detail_size 接受按面板命名的宽高比例列表,NULL 使用 Fusion 默认分配;区域重叠会报错。标准保存按目标尺寸重建面板和引线。小画布需要 检查标签并适当增大尺寸。引线可能穿过主图或相互交叉,全局避障是独立策略;显式嵌套与矩形区域分配见后文。
4 精确关联源坐标的字符细节
普通 Cartesian 字符图通过 register_ggchord_alignment() 可成为独立细节面板。注册实际显示的字符行:x为原始对齐列/编码列,y为对齐行ID,label为真实字符。源映射与普通 ggplot 标度保持独立。以下真实30列片段保留上游 gap 和 mismatch;宏观长度表示去gap后的对齐片段,不是完整基因组。短标签仅用于显示,原始记录 ID 保留。
R · 示例代码
library(dplyr)
cells <- sequence_detail_example$dna_alignment
rows <- unique(cells$accver)[c(1, 3)]
window <- cells |>
  filter(accver %in% rows, between(alignment_column, 321, 350))
sequences <- cells |>
  filter(accver %in% rows, !is_gap) |>
  group_by(accver) |>
  summarise(length = max(source_position), .groups = "drop")
regions <- window |>
  filter(!is_gap) |>
  group_by(source_accver) |>
  summarise(start = min(source_position), end = max(source_position), .groups = "drop") |>
  rename(accver = source_accver)
letters <- ggplot2::ggplot(window, aes(alignment_column, accver, label = symbol)) +
  geom_residue(overflow = "error", show.legend = FALSE) +
  ggplot2::scale_y_discrete(limits = rev(rows),
    labels = setNames(c("AF191661.1", "AF191659.1"), rows),
    expand = expansion(add = 0.6)) +
  ggplot2::scale_x_continuous(breaks = seq(321, 350, 5), expand = expansion(add = 0.6)) +
  labs(title = "Aligned nucleotide detail", x = "Alignment column", y = NULL) +
  ggplot2::theme_minimal(base_size = 12) +
  theme(panel.grid = element_blank(), plot.title = element_text(face = "bold"),
    axis.text = element_text(colour = "#25363B"))
letters <- register_ggchord_alignment(letters, window)
macro <- ggchord(sequences) +
  geom_seq(aes(seq_colour = accver), show.legend = FALSE) +
  geom_seq_label(labels = setNames(c("AF191661.1", "AF191659.1"), rows), size = 3.5) +
  coord_collinear() +
  labs(title = "Sequence context") +
  theme_ggchord_publication()
character_detail <- magnify_ggchord(
  macro, regions, letters,
  center_box = c(.01, .28, .20, .85), detail_box = c(.33, .99, .15, .85),
  connector = "envelope", colour = "#725094", highlight_width = 3
)
export_ggchord_fusion(character_detail, width = 16, height = 5)$focus_regions
# ggsave("character-detail.png", character_detail, width = 16, height = 5)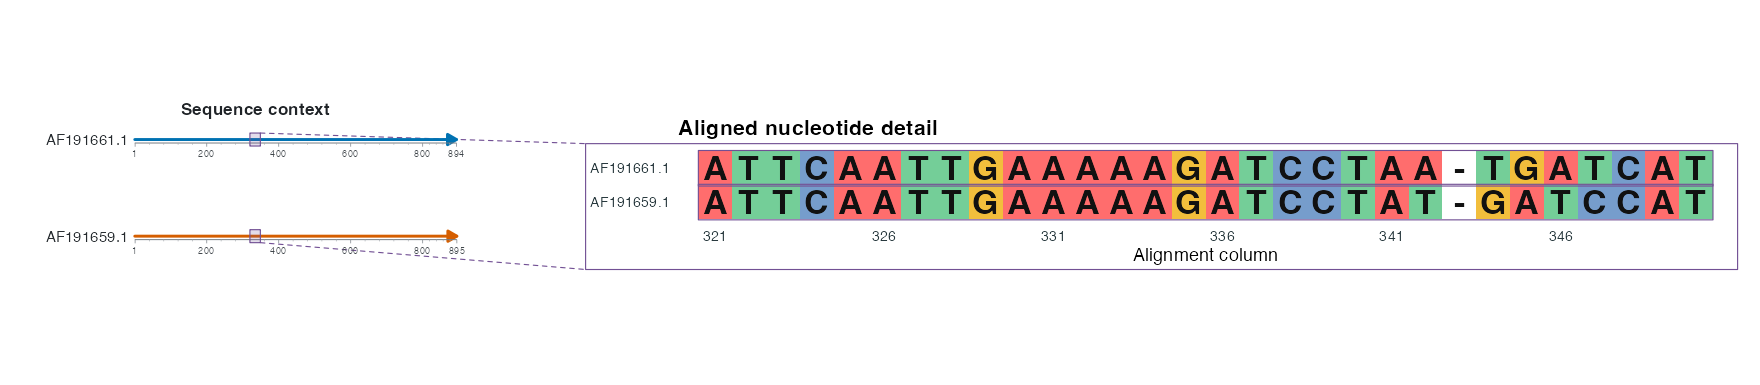
普通图仍可编辑,各自颜色、图层与注释保持独立。支持 identity/reverse x 标度和离散 y 行。Fusion 每次构建都核对修改后的字符位置/标签,并重新测量最终面板毫米边界;半格边界对应真实端点字符。gap 无源位置,不会被插值为碱基。选区必须按生物学顺序包含全部已选源碱基,内含子需拆成独立源区间,跨原点区域使用后文的显式环绕声明。同一来源有多个对齐行时用 detail_instance 明确选择。不注册的 ggplot、分面、非线性/翻转坐标和移动已注册字符均报错。
translate_ggchord_cds() 的碱基行可以同样注册。按 examples/m2-detail.R 将翻译标在 codon 中心,完整跨段 codon 来源查 source_positions。AA残基行使用独立aa坐标域,基因组bp宏观图直接连接aa位置仍需显式CDS投影。magnify装饰引线与生物学Fusion连接分开;字符端点没有骨架颜色可用于渐变,应明确提供跨面板fill。窄画布仍执行 geom_residue() 的tile/error策略,应增加物理尺寸,不能只增加DPI。全局引线避障是独立布局问题;下文提供显式嵌套和自由区域分配。